廣瀬先生の論文が日本統計学会誌に掲載されました

論文タイトル

ランダムでない欠測を含む時系列モデリング

●

時系列データに欠測がある場合、一般的な状態空間モデルによる補完は、欠測がランダムに生じることを仮定しています。本論文では、ランダムでない欠測に対して欠測確率をモデル化し、推定のバイアスを小さくするパラメータ推定法と欠測補完法を提案しました。モンテカルロEMアルゴリズムを用い、シミュレーションにより有効性を検証しています。

採択日:2024年2月27日

執筆者  ※所属は論文作成当時/敬称略

馬場 由羽貴九州大学 大学院数理学府
廣瀬 慧九州大学 マス・フォア・インダストリ研究所

王 際強君(D1)のポスター発表が「The 12th conference of the Asian Regional Section of the International Association for Statistical Computing (IASC-ARS)」でOutstanding Young Researcher/Student Poster Presentation Awardに選出されました

ポスタータイトル

SSVD Based Biclustering Methods via Mixed Prenet Penalty

発表者

Jiqiang Wang and Kei Hirose

Abstract:

Standard clustering methods typically group samples based on their entire set of observed features. In large datasets, however, only a few features may play a role in distinguishing different clusters.

In our research, we observed that if certain biclusters produced by the algorithm are excessively similar, which means they have a high degree of repetition (overlap). Such redundancy can pose challenges to our analysis because it is difficult to identify the useful variables. On the other hand, these repeated portions may also contain valuable information. However, a simple prohibition or allowance of repetition is not sufficient. We need to find a method to identify when it is necessary to retain duplicated parts. In our study, we successfully improved the SSVD (Sparse Singular Value Decomposition) by proposing the following mixed Prenet penalty (a hybrid of Prenet (product-based elastic net) penalty and the original elastic net penalty) to replace the original adaptive Lasso penalty in the SSVD method.

The Prenet penalty was originally proposed by Hirose and Terada (2022) to deal with the loading matrix in Factor analysis. It is based on the product of a pair of elements in each row of the loading matrix. The Prenet not only shrinks some of the factor loadings toward exactly zero but also enhances the simplicity of the loading matrix, which plays an important role in the interpretation of the common factors. However, the original Prenet penalty itself cannot provide a good clustering result in our experience, then we extended it to make it compatible with the general elastic net and allow users to easily control the threshold for allowing overlapping by adjusting parameter values. This improvement has a noticeable effect on reducing the degree of dummy overlapping.

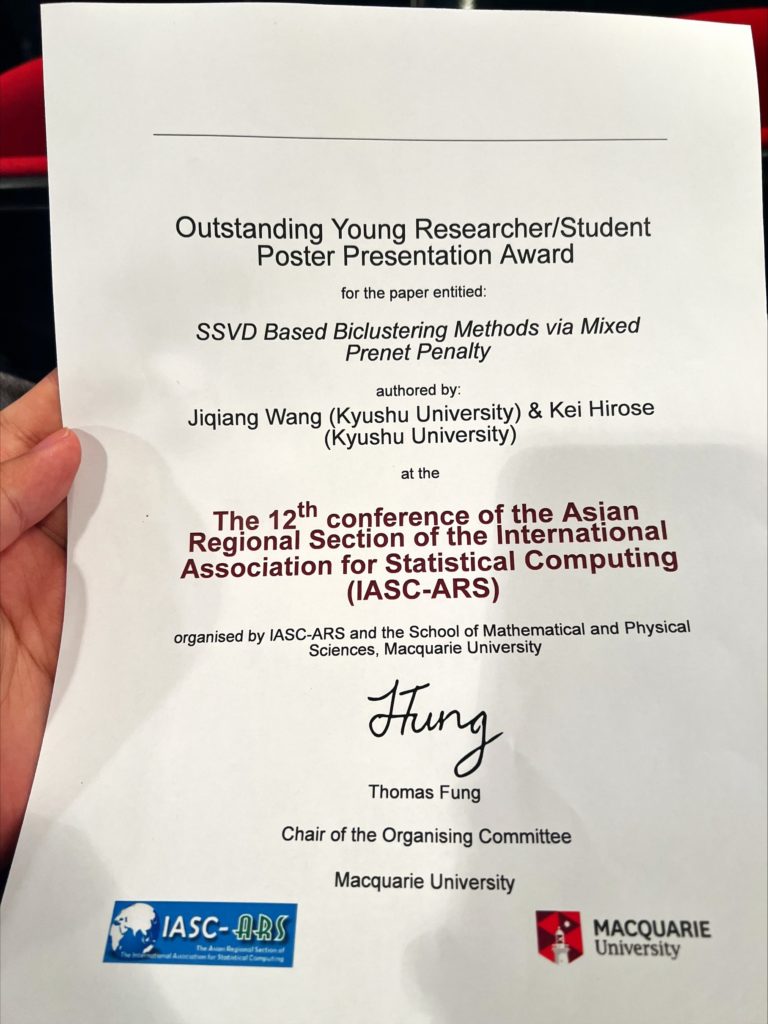
受賞日
2023年12月8日

廣瀬先生の論文がComputational Statistics & Data Analysisに掲載されました

論文タイトル

Fast same-step forecast in SUTSE model and its theoretical properties

●

本論文は、SUTSEモデルを用いた多変量時系列予測に関する研究です。通常まとめて行われるモデル推定と予測誤差の相関推定を二段階に分けることで、大規模な行列計算を回避する高速予測法を提案しました。バスの混雑度予測では、約11時間を要した解析を約8秒で実行し、予測精度にも大きな差がないことを確認しています。

採択日:2023年9月24日

執筆者  ※所属は論文作成当時/敬称略

吉田 航九州大学 大学院マス・フォア・イノベーション連係学府
廣瀬 慧九州大学 マス・フォア・インダストリ研究所

廣瀬先生の論文がComputational Statistics & Data Analysisに掲載されました

論文タイトル

Hierarchical clustered multiclass discriminant analysis via cross-validation

●

通常の線形判別分析では、分類が難しいクラスを含む場合に予測精度が低下することがあります。本論文では、交差検証値をクラスター間の非類似度として用いる階層的クラスタリングと線形判別分析を組み合わせた手法を提案しました。回帰表現を利用した高速な近似計算法により、人工データと実データの双方で高い予測精度と計算効率を示しています。

採択日:2022年9月2日

執筆者  ※所属は論文作成当時/敬称略

廣瀬 慧九州大学 マス・フォア・インダストリ研究所
三浦 完太九州大学 大学院数理学府修士課程 2020年度修了
小家 亜斗吏九州大学 大学院数理学府修士課程 2017年度修了

廣瀬先生の論文がPsychometrikaに掲載されました

論文タイトル

Sparse and simple structure estimation via prenet penalization

●

因子分析では、因子負荷量をスパースで解釈しやすい構造として推定することが重要です。本論文では、因子負荷量の積に基づく新しい正則化法「prenet」を提案しました。正則化の強さを調整することで、負荷量をゼロに縮小すると同時に、各変数が単一の因子に対応する単純構造を推定できます。

採択日:2022年4月13日

執筆者  ※所属は論文作成当時/敬称略

廣瀬 慧九州大学 マス・フォア・インダストリ研究所
寺田 吉壱大阪大学 基礎工学研究科

廣瀬先生の論文がFrontiers in Energy Researchに掲載されました

論文タイトル

Interpretable modeling for short- and medium-term electricity demand forecasting

●

本論文では、過去の需要と日々の気象予報を用いた短期・中期の電力需要予測を扱っています。気象が需要に与える非線形な影響を、基底展開を用いた変化係数モデルと非負最小二乗法によって表現し、解釈しやすい予測モデルを構築しました。実データへの適用により、気象や新型コロナウイルス感染状況の影響を捉えながら、高い予測精度を得られることを示しています。

採択日:2021年11月1日

執筆者  ※所属は論文作成当時/敬称略

廣瀬 慧九州大学 マス・フォア・インダストリ研究所

廣瀬先生の論文がNumerical Methods in Engineeringに掲載されました

論文タイトル

Sparse multivariate regression with missing values and its application to the prediction of material properties

●

材料科学では、複数の材料特性を同時に予測する際に、目的変数に多くの欠測が含まれることがあります。本論文では、回帰係数と目的変数の逆共分散行列をスパースに推定し、欠測値の補完も行う多変量回帰法を提案しました。22種類の材料特性を含む実データに適用し、変数間の相関を活用した予測の有効性を示しています。

採択日:2021年10月25日

執筆者  ※所属は論文作成当時/敬称略

寺本 圭祐広島大学 大学院先進理工系科学研究科 数学プログラム
廣瀬 慧九州大学 マス・フォア・インダストリ研究所

混雑度予測アプリ「itocon」の予測アルゴリズムについて,修士課程2年・吉田君の解説した記事が「九大理学部ニュース」に掲載されました

「itocon」は,九州大学伊都キャンパス周辺のバス停の混雑度をリアルタイムで可視化するアプリです.
(開発:九州大学 大学院システム情報科学研究院 ヒューマノフィリックシステム研究室)

吉田君は,混雑の予測を算出するアルゴリズムを構築しました.
アルゴリズムの仕組みについて,吉田君が「九大理学部ニュース」で詳しく解説しています.

2021年度統計関連学会連合大会で三浦君,馬場君,吉田君が口頭発表を行いました

学会名 2021年度統計関連学会連合大会
発表日 2021年9月5日~9日
開催形式 オンライン

発表者と講演タイトル(敬称略)

9月7日 三浦 完太(修了生)  
廣瀬 慧
クロスバリデーションに基づく正準判別のクラスタリングとその高速化
9月8日 馬場 由羽貴(修士2年) 
廣瀬 慧
NMARにおける状態空間モデルの推定
9月9日 吉田 航(修士2年)
廣瀬 慧
適切な誤差分散推定によるモデル選択後の予測精度向上

修了生の三浦君, 小家君と共著の論文がプレプリントで公開されました

論文タイトル

Hierarchical clustered multiclass discriminant analysis via cross-validation.

●

本論文では,クラスタリングを用いた高精度な正準判別分析を提案しました.階層的クラスタリングを用いており,クラスタリングの指標としてクロスバリデーションを用いることを考案しました.このとき,クラスタリングの各ステップでクロスバリデーションを計算する必要があるため,計算時間がかかります.そこで,高速に計算するアルゴリズムを構築しました.このアルゴリズムは,hcldaというRパッケージで実行でき,githubに公開されています.


執筆者(敬称略)

廣瀬 慧(九州大学 マス・フォア・インダストリ研究所)
三浦 完太(九州大学 大学院数理学府修士課程 2020年度修了)
小家 亜斗吏(九州大学 大学院数理学府修士課程 2017年度修了)

三浦君のコメント

この論文は,小家先輩の判別分析の際に似ている群をあらかじめクラスタリングするというアイデアを元に作成しました.ここで用いたクラスタリング手法は階層的クラスタリングを参考にしたものを用いています.先生と共同でこの論文内容のRパッケージも作成しており,貴重な経験が出来たと思います.


廣瀬先生の論文がScientific Reportsに掲載されました

論文タイトル

Relationship between gene regulation network structure and prediction accuracy in high dimensional regression.

●

植物の遺伝子から形質を予測する際,通常Lassoなどの高次元回帰モデルが用いられますが,遺伝子ネットワークと予測精度の関係性についてはこれまであまり議論されていませんでした.本論文では,その関係性をモンテカルロシミュレーションによって検証しました.

研究内容の詳しい解説が『九大理学部ニュース』に掲載されています.

執筆者  ※所属は論文作成当時 / 敬称略

沖永 悠一(九州大学 大学院数理学府)
京極 大助(兵庫県立人と自然の博物館 自然・環境マネジメント研究部)
近藤 聡(トヨタ自動車(株)アグリバ イオ事業部 農食事業室)
永野 惇(龍谷大学 農学部)
廣瀬 慧(九州大学 マス・フォア・インダストリ研究所)

修士課程2年・吉田航君が作成した混雑予測アルゴリズムがアプリ「itocon」で活用されています

九大生がよく利用するバス停(昭和バス・西鉄バス)の混雑度をリアルタイムで可視化するアプリ(Web版・LINE版)

アプリ管理・運営 / 九州大学 大学院システム情報科学研究院 ヒューマノフィリックシステム研究室

吉田君のコメント

今回, アプリに実装していただいたアルゴリズムは, 次の日のバスの混雑度を, その日までのデータを用いて予測するものです.使用したモデルは, 状態空間モデルというモデルです. その中でも, ARモデルとローカルレベルモデルというモデルを組み合わせたものを使用しました. この2つのモデルは昔からよく知られるシンプルなモデルであります. 予測には, 前日までのバスの混雑度のみを使用します. イベント情報や気象情報など, 様々なデータを元に, 複雑なモデルを立てて予測することも考えられますが, 今回の解析ではシンプルなモデルの方が合っていると考えました. 実際に中々上手くいってくれて, 178日分のデータに対して予測の平均2乗誤差が, 8.64人^2程でした.
今回実装していただいたのは翌日の混雑度を予測するアルゴリズムですが, 今後として, 当日のある時刻の混雑度をその時刻以前のデータを元に予測をする, 当日予測を考えています.

修士課程2年・馬場由羽貴君が参加した研究インターンシップがC-ENGINEの成果事例として紹介されました

C-ENGINE(一般社団法人 産学協働イノベーション人材育成協議会)実施のインターンシップに参加

実施期間2020年8月~10月の2ヶ月間
受入企業川崎重工業株式会社 技術開発本部 (リモートによる実施)

馬場君のコメント

去年の10月にC-ENGINEを通して川崎重工業での研究インターンシップに取り組みました. 実験データの取得やデータの前処理など, 普段の研究では経験できないようなデータ解析に取り組むことができ, 非常にいい経験になりました. 今回の経験を生かして,これからも実用場面を意識した研究を行っていきます.